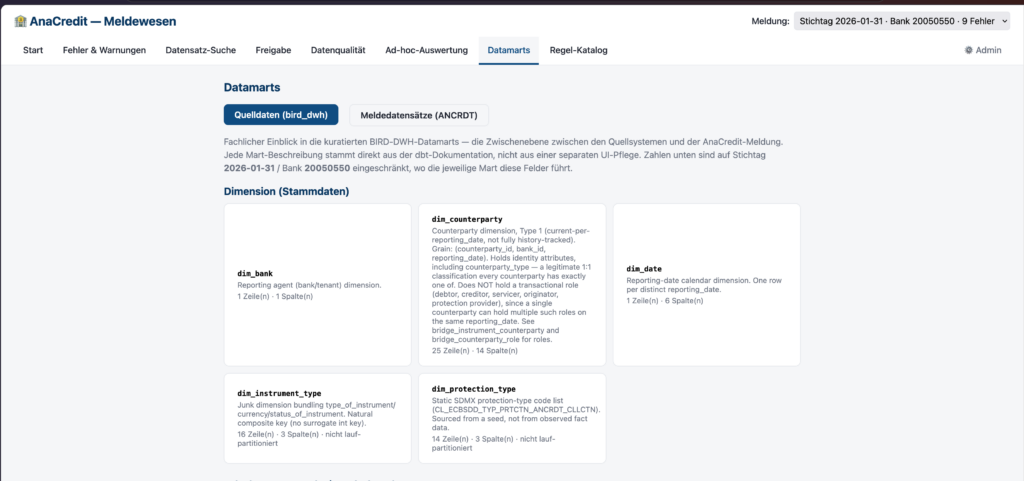
Die erste Stufe auszuarbeiten war für mich dank AI Unterstützung nicht sonderlich schwer.
BIRD ist wirklich gut dokumentiert, neu für mich war dagegen der komplette Neudesign für ein DWH. Ich hatte vorher schon das Glück, in einem DWH Umfeld zu arbeiten, eines aber auf der grünen Wiese ohne Restriktionen zu entwerfen. Das hat schon Spaß gemacht. Wie in guten Studiumszeiten – nur damals ging es um „normale“ Datenbanken. Das ist lange her 🙂
Die komplette BIRD Struktur habe ich mir erstmal nicht vorgenommen; an meine angedachte 6-Schichten Architektur habe ich mich gehalten.
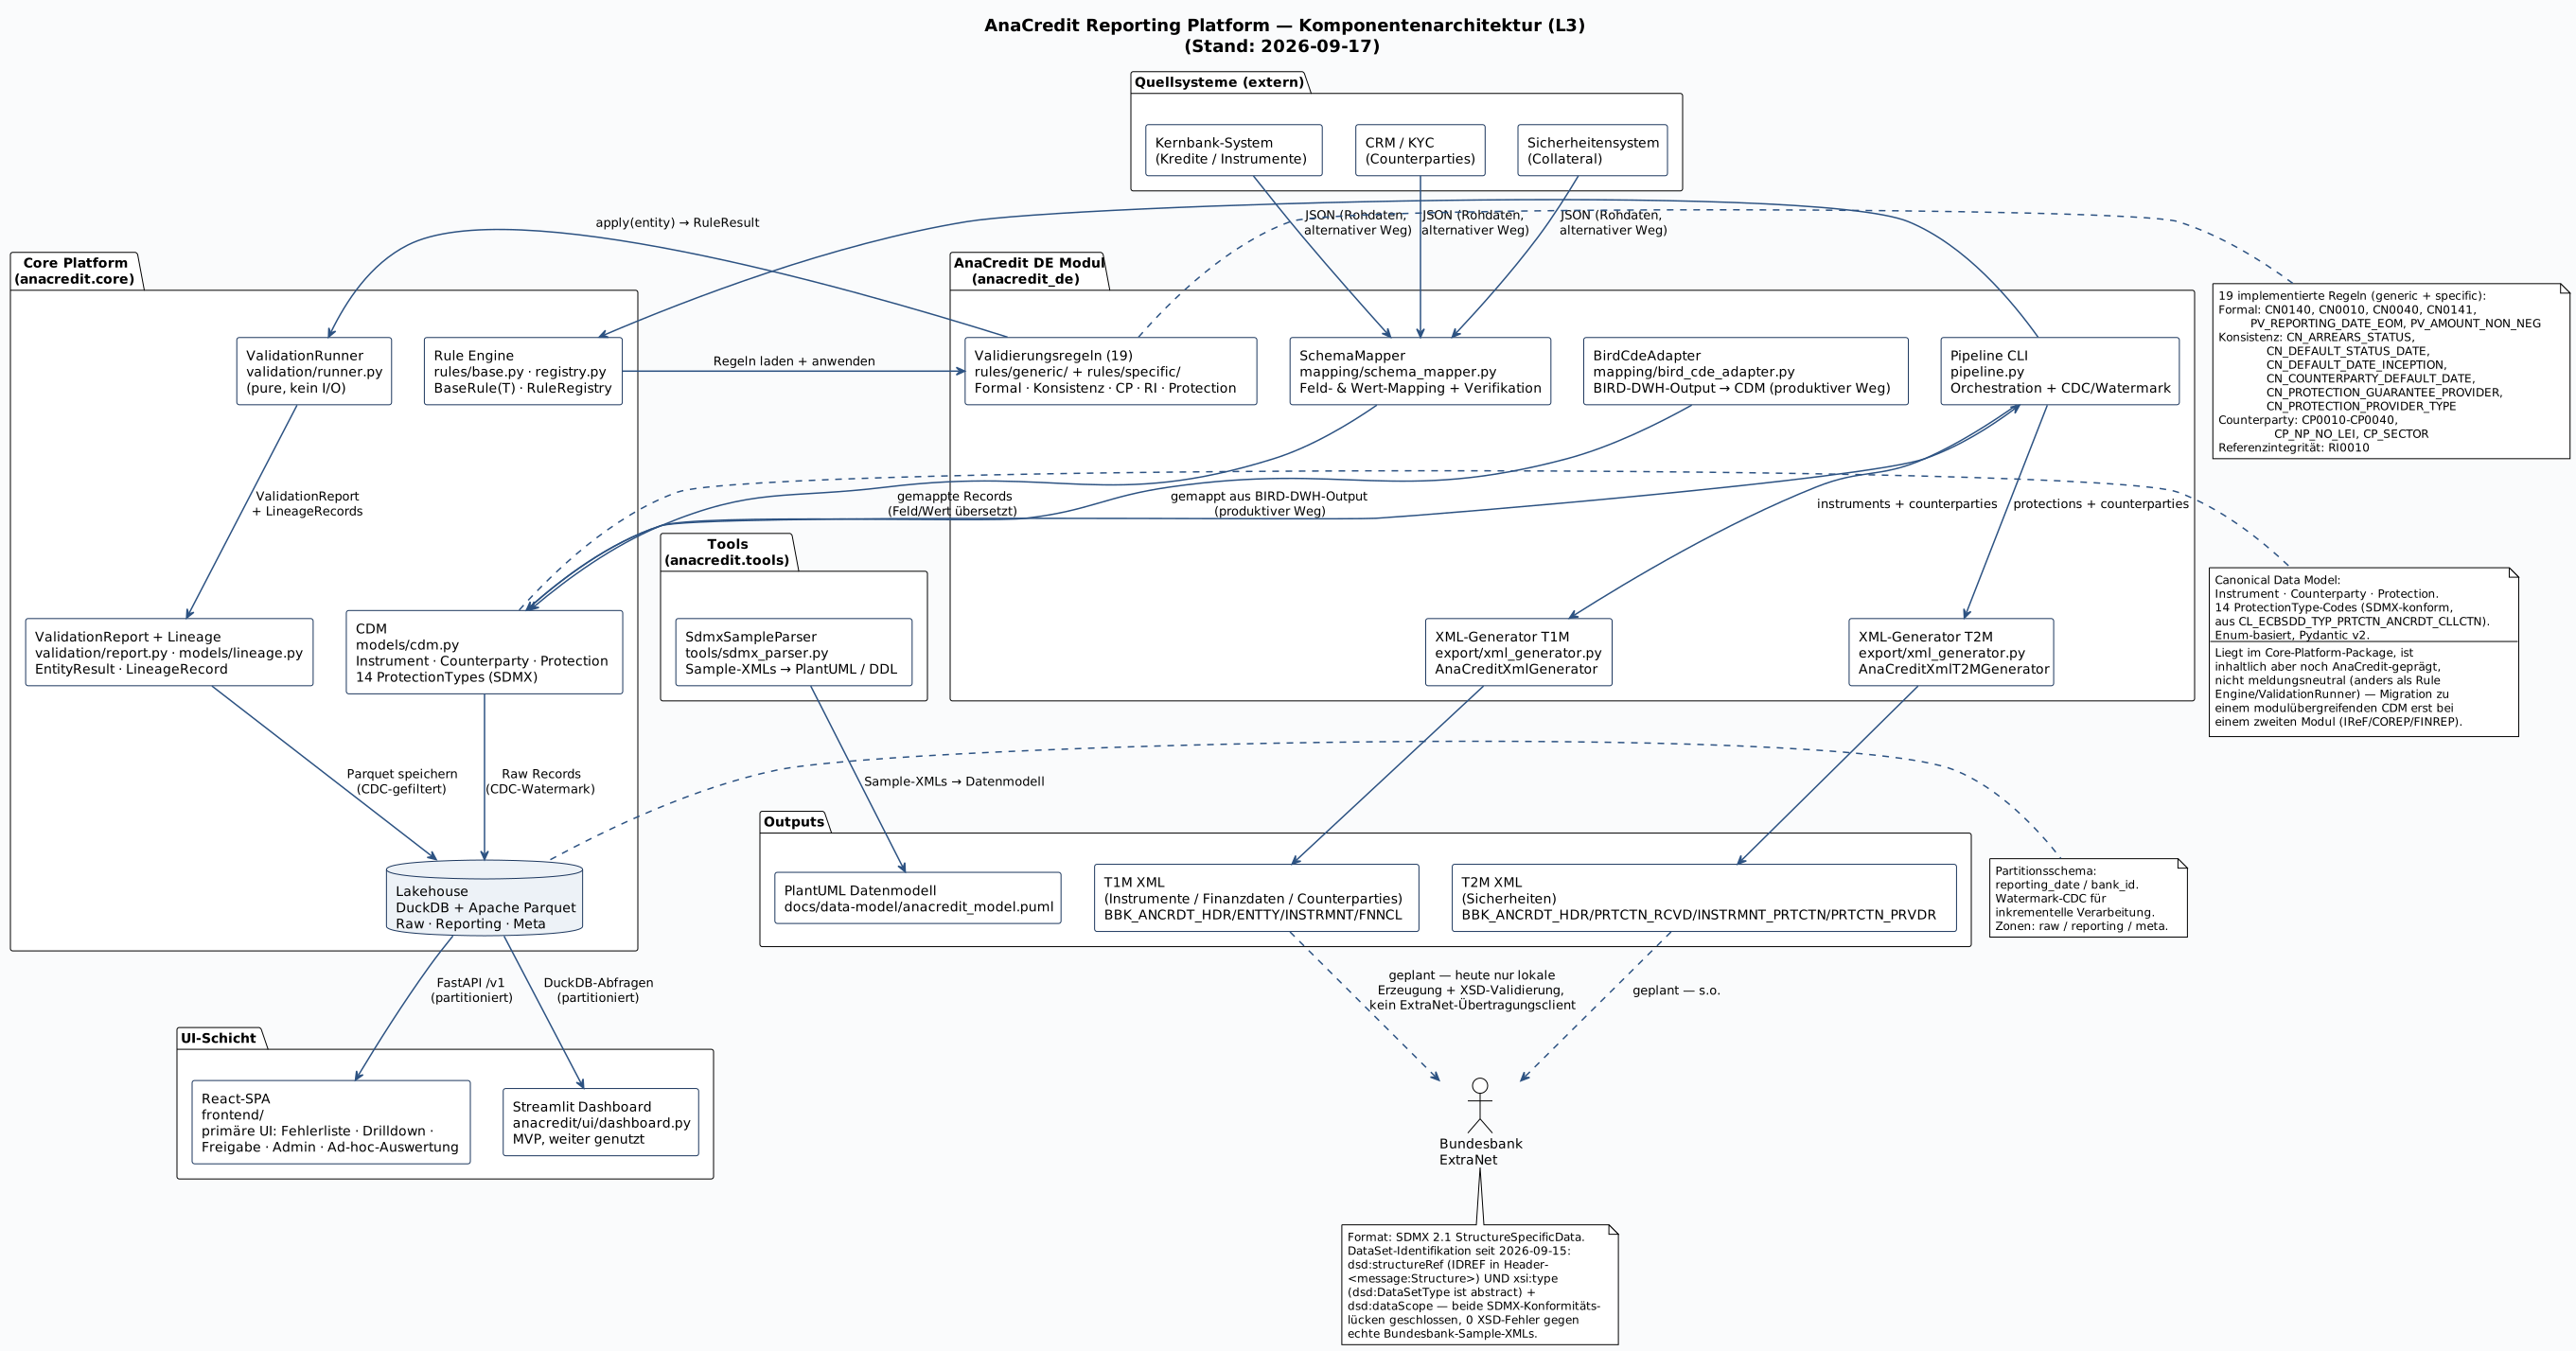
Diese Architektur habe ich dann weiter heruntergebrochen. Meine angedachte Agentenstruktur sieht dann wie folgt aus.
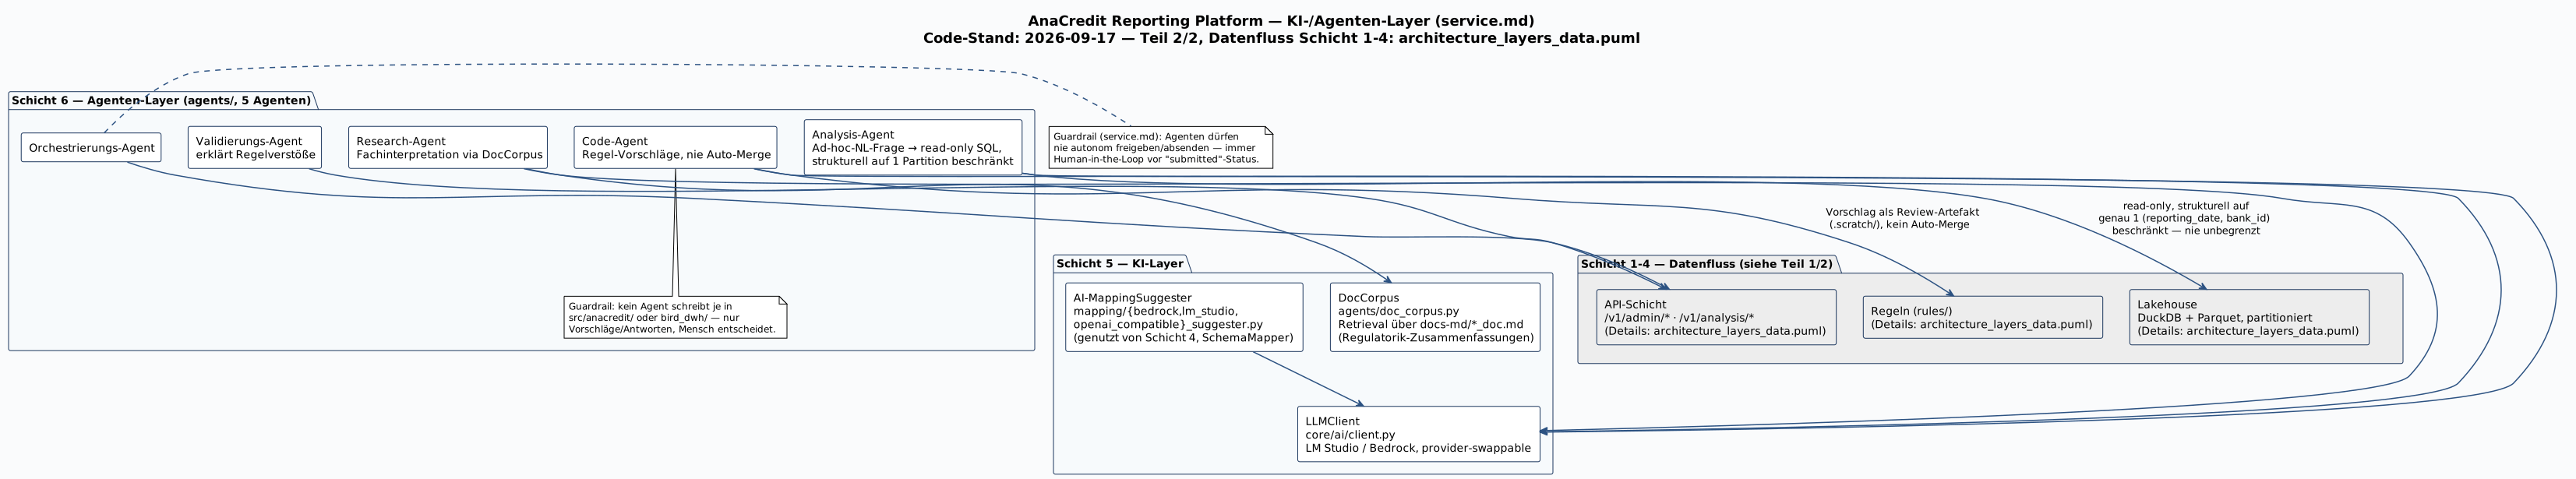
PlantUML hat so seine Tücken; ich versuche im Projekt soviel OpenSource einzusetzen wie möglich. In der Dokumentation fängt es an, hört wahrscheinlich später bei den OpenSource Modellen auf.
Aber nun zu den Eckpunkten meines kleinen Projektes.
Quellsysteme (extern)
- Kernbank-System / CRM / Sicherheitensystem — die drei fachlichen Herkunftssysteme für Instrumente, Geschäftspartner und Sicherheiten. Kein Code ist hierfür im Repo, aktuell nur durch synthetische JSON-Fixtures simuliert.
AnaCredit-Bundesbank-Modul
- SchemaMapper (
mapping/schema_mapper.py) — übersetzt die Feldnamen und Werte eines Quellsystems auf die CDM-Bezeichnungen. Lädt dazu JSON-Mapping-Dateien jesource_system, entity_type. Wichtiges Sicherheitsdetail: unverifizierte Mappings werden übersprungen (Feld bleibt unverändert) — das verhindert, dass ein ungeprüfter KI-Vorschlag stillschweigend Daten verfälscht. - Pipeline CLI (
pipeline.py) — dünner Typer-CLI-Wrapper umservice.py::execute_pipeline(), inkl. CDC/Watermark-Steuerung für die inkrementelle Läufe. - Validierungsregeln (
rules/generic/+rules/specific/) — die konkreten fachlichen Prüfungen (Formal, Konsistenz, Counterparty, Referenzintegrität, Protection) gem. der offizielen veröffentlichten Dokumente. - XML-Generator T1M/T2M (
export/xml_generator.py→AnaCreditXmlGenerator,AnaCreditXmlT2MGenerator) — erzeugen die SDMX-2.1-konformen Meldungsdateien; T1M für Instrumente/Finanzdaten/Counterparties, T2M für Sicherheiten.
Core Platform
- CDM (
core/models/cdm.py) — Beinhaltet momentan nur das kanonische, AnaCredit-eigene Datenmodell (Pydantic v2):Instrument,Counterparty,Protection+ Enums/Code-Listen. - Rule Engine (
core/rules/base.py+registry.py) — das Framework dahinter:BaseRule[T]als abstrakte Basisklasse, die jede Regel implementiert (apply()als reine Funktion, kein I/O), undRuleRegistryals zentraler, klassenweiter Speicher aller registrierten Regeln nach(rule_id, version). - ValidationRunner (
core/validation/runner.py) — wendet die registrierten Regeln auf CDM-Entities an und erzeugt einenValidationReport. Bewusst zustandslos, macht selbst kein I/O — das Speichern übernimmt die aufrufende Pipeline. - ValidationReport + Lineage (
core/validation/report.py,core/models/lineage.py) — der Ergebnis-Container eines Laufs (EntityResult,LineageRecord); unveränderlich nach Erstellung. - Lakehouse (DuckDB + Parquet) — die Storage-Schicht, partitioniert nach
reporting_date/bank_id, in Zonenraw/reporting/meta.
Tools
- SdmxSampleParser (
tools/sdmx_parser.py) — Entwickler-Werkzeug, der das echte Bundesbank-Sample-XMLs zurück in ein Datenmodell (PlantUML/DDL) übersetzt — kein Laufzeitbestandteil, nur zur Verifikation gegen reale Meldeschemata
Outputs / Bundesbank
- T1M/T2M XML — die generierten Meldedateien.
- Bundesbank ExtraNet (im Diagramm als Actor) — Tatsächlich gibt es aktuell keinen ExtraNet-Übertragungsclient — nur lokale XML-Erzeugung + XSD-Validierung (die seit 15.09. mit 0 Fehlern gegen die echten Bundesbank-Schemas läuft).
UI
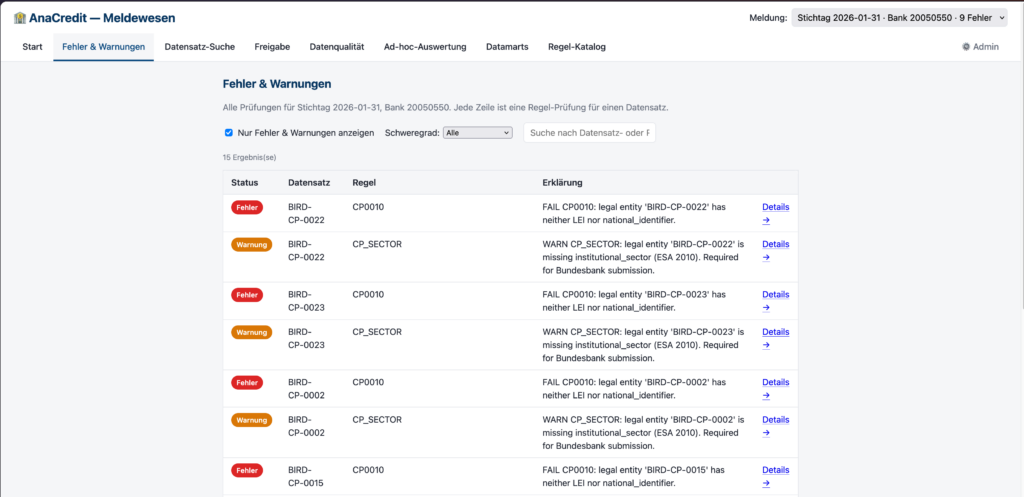
Streamlit Dashboard (ui/dashboard.py) — Eine grafisches Dashboard, welches eine Übersicht, Fehlerliste, Drilldown, und Lineage beinhaltet. Mittlerweile existiert daneben auch die React-Site als primäre Oberfläche.
Architektur: Core Platform + Reporting Module
Die angedachte Plattform trennt bewusst zwei Schichten:
- Core Platform: das gemeinsame Fundament mit Rule-Engine-Framework, Storage-Abstraktion, Lineage-/Submission-Workflow-Mechanik. Architektonisch für zukünftige, weitere Reporting-Module vorgesehen. Im Moment ist hier nur AnaCredit vorhanden.
- Reporting Module (
anacredit_de): alles Meldungsspezifische — Validierungsregeln aus den Bundesbank-Handbüchern, SDMX-XML-Export, Mapping von Quellsystemen auf das CDM.
Diese Trennung ist kein Selbstzweck: Sie ist die Voraussetzung dafür, dass später eine zweite Meldung (oder ein zweites Quellsystem) angebunden werden kann, ohne dabei die Core-Schicht anzufassen und abändern zu müssen.
Die Mechanismen im Core sind bereits meldungsneutral — die Rule-Engine kennt keine AnaCredit-Regeln, nur die Abstraktion dahinter.
Das Canonical Data Model (CDM) liegt zwar ebenfalls im Core, ist inhaltlich aber noch vollständig AnaCredit-geprägt: Enums wie TypeOfInstrument orientieren sich wörtlich an AnaCredit Annex IV, ProtectionType folgt 1:1 einer AnaCredit-SDMX-Codeliste.
Es liegt dort verortet, weil AnaCredit bislang das einzige Modul ist — nicht, weil es bereits modulübergreifend generisch wäre. Eine echte Migration zu einem meldungsneutralen CDM steht erst an, sobald ein zweites Modul (eine der IReF-Meldungen, COREP, FINREP) tatsächlich kommt bzw. ich vielleicht noch mehr Zeit finde.
Ein Punkt, der gegebenenfalls missverstanden werden kann: das CDM ist auch nicht BIRD-konform. Vorgelagert existiert ein bewusst generisches, BIRD-konformes Data Warehouse (eigenes dbt-Projekt, Star-Schema-Output-Layer) — absichtlich nicht auf AnaCredit zugeschnitten, damit später auch andere Meldungen wie IReF, COREP oder FINREP aus derselben Quelle lesen könnten. Das CDM selbst bleibt trotzdem ein eigenes, AnaCredit-spezifisches Modell; ein Adapter übersetzt die generischen BIRD-Daten hinein. Die Schreibrichtung ist dabei eine bewusste Einbahnstraße: Die Reporting-Module lesen nur aus dem BIRD-DWH, schreiben nie einen einzelnen Datensatz zurück.
Lakehouse-Design: für granulare, wiederkehrende Meldeläufe
Instrument-level Daten bedeuten potenziell sehr viele Zeilen, und Meldungen laufen wiederkehrend für jeden Stichtag.
Das Storage-Design ist entsprechend auf zwei Dinge optimiert:
- Partitionierung nach
reporting_dateundbank_id(produktiv als Iceberg-Hidden-Partitioning gedacht, lokal als DuckDB + Parquet mit identischer Verzeichnisstrukturzone/entity/reporting_date=.../bank_id=.../data.parquetumgesetzt) — jede Query und jede Validierung filtert zwingend auf diese beiden Schlüssel, unbegrenzte Scans sind architektonisch ausgeschlossen. - Inkrementelle Verarbeitung statt Full-Reload: Ein Vollabgleich ist die Ausnahme, kein Standardfall. Der Merge neuer/geänderter Instrumente läuft als vektorisierte SQL-Operation noch lokal direkt in DuckDB — das hat den Import eines 5.000-Zeilen-Deltas in eine 500.000-Zeilen-Partition von rund 4 Sekunden auf einen Bruchteil davon beschleunigt, einfach weil die Arbeit in einer spaltenorientierten Engine passiert statt in einer Python-Schleife.
Wichtige Ergänzung: Das beschreibt nur die Verarbeitungsmechanik — wie effizient ein einzelner Lauf ein Delta einspielt. Es sagt noch nichts darüber aus, wann ein Lauf für einen Stichtag überhaupt starten bzw. bis zur Freigabe durchlaufen darf.
Diese zweite Achse (Datenreife/Vollständigkeit — z.B. Monatsabschluss-Buchungsläufe, die noch nicht durch sind) wird separat über ein Readiness-Gate abgesichert: Ein Quellsystem muss explizit „Buchungsschluss erreicht“ melden, bevor eine Meldung zur menschlichen Freigabe weitergeleitet werden kann — ein Mensch soll nicht selbst prüfen müssen, ob die verfügbaren Daten vollständig sind.
Der lokale Stack (DuckDB/Parquet) ist bewusst so gebaut, dass er 1:1 auf Trino/Iceberg umgestellt werden kann, ohne die Query-Schnittstelle zu ändern.
Regeln, Validierung, Lineage
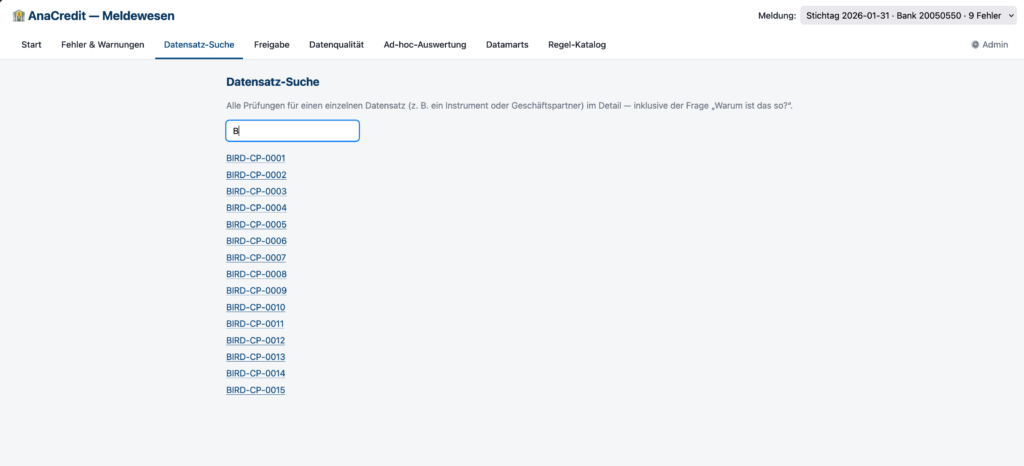
Jede einzelne fachliche Prüfung — von formalen Konsistenzchecks bis zu komplexen Plausibilisierungsregeln aus dem Bundesbank-Handbuch — ist eine versionierte Rule-Klasse, kein Hardcoding irgendwo in einer ETL-Pipeline. Jede Regel-Ausführung erzeugt einen Lineage-Eintrag: Quelle zu Regel zu Zielattribut, inklusive einer für den Fachbereich lesbaren Erklärung. Diese Lineage-Daten sind die Grundlage für die Beantwortung der Frage „Warum ist das so?“-Erklärung in der Oberfläche und für den Drilldown vom Fehler bis zum einzelnen Attribut.
Vom Streamlit-Prototyp zur React-Oberfläche
Der Weg war hier bewusst iterativ gewählt: Streamlit-MVP für die ersten, persönlichen Fachtests, FastAPI als stabile HTTP-Schnittstelle . Gegen Ende dann die Migration zur React-SPA für den möglichen produktiven Einsatz durch Bank-Mitarbeitende.
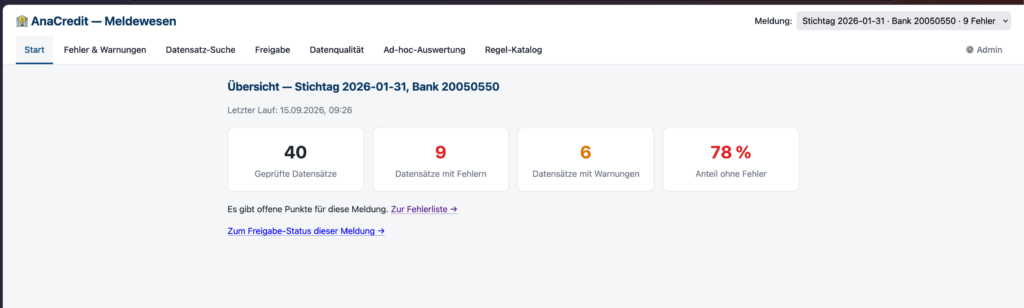
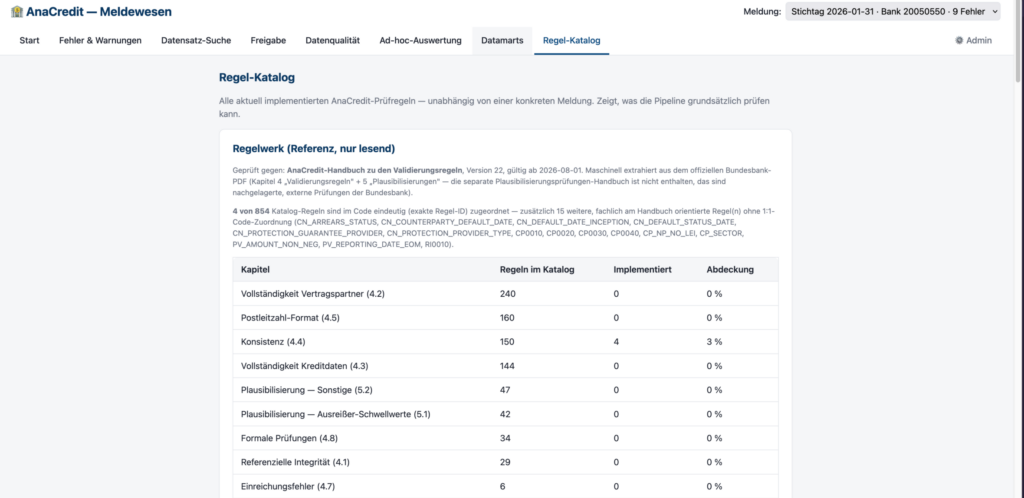
EDIT 13.10.26: Zugegeben, das ist noch ein kleiner Datenbestand. Ich habe mittlerweile diesen Prozess mit 1 Mio. Datensätzen vertestet; lokal war der Prozess nach 30 Minuten am Ende. Auch hier eine kleine Einschränkung. Es sind nicht alle AnaCredit Regeln im Einsatz bzw. überführt worden. Das lässt sich vielversprechend an.

Die Lakehouse-Schicht darunter blieb dabei unverändert — nur die Präsentationsschicht wurde ausgetauscht: ein gutes Beispiel dafür, dass sich eine saubere Trennung von Storage und UI langfristig auszahlt. An der Stelle hatte ich dann wenig Probleme, das lief sauber durch.
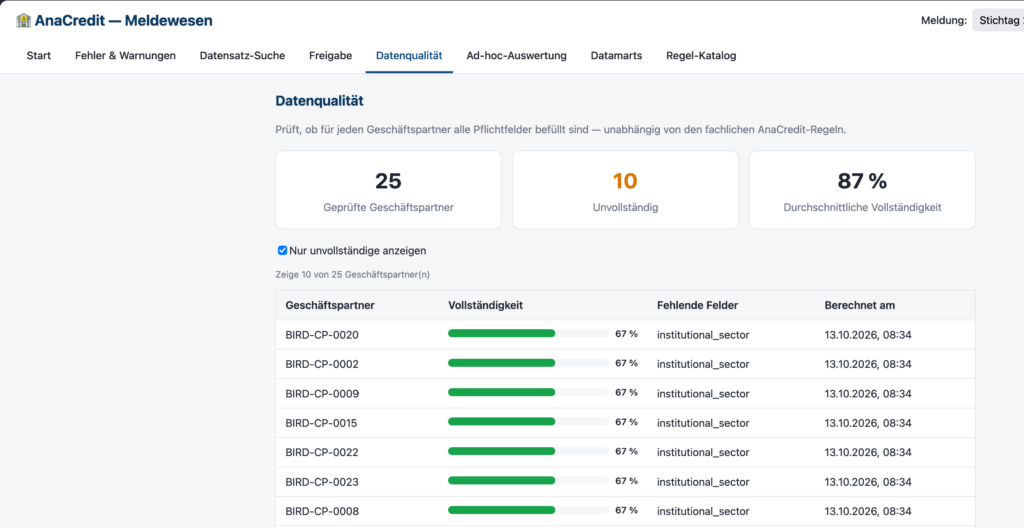
Endlich mal eine schöne Oberfläche – ohne im Menü komplett verloren zu gehen.
Ein Agenten-Layer mit Guardrails statt Blackbox-KI
Vier spezialisierte Agenten unterstützen den Fachbereich: ein Validation-Agent erklärt Regelverstöße in verständlicher Sprache, ein Research-Agent durchsucht die AnaCredit-Fachdokumentation, ein Orchestrator koordiniert die Agentenkollegen, und ein Code-Agent kann neue Validierungsregeln oder Analysen als Entwurf voschlagen — schreibt aber nie selbst in den Code. Jeder Vorschlag landet als Review-Artefakt, ein Mensch muss ihn prüfen und am Ende übernehmen.
Kurzer qualitativer Einwurf: Momentan läuft alles lokal, auch meine lokalen LLMs. Das hat gerade Einfluss auf die Bearbeitungsgeschwindigkeit der Fragen und auch deren Qualität. Es geht mir aber hier mehr darum zu zeigen: es geht. Vielleicht nimmt sich der ein oder andere hier einen Gedankenimpuls mit.
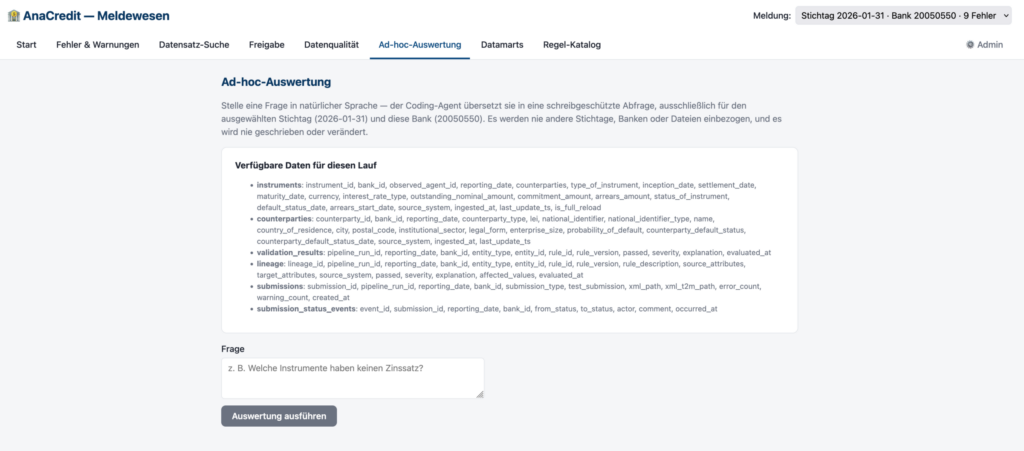
Kürzlich kam ein fünfter Baustein dazu: Ad-hoc-Analyse per natürlicher Sprache. Ein Fachanwender stellt eine Frage wie „Welche Instrumente haben keinen Zinssatz?“, ein LLM übersetzt das in eine SQL-Abfrage — aber diese Abfrage läuft nie ungeschützt gegen den gesamten Datenbestand. Die Sicherheitsarchitektur dahinter:
- Jede Abfrage sieht strukturell nur die Daten eines einzigen Stichtags und einer einzigen Bank — nicht weil die generierte SQL das brav einhält, sondern weil die zugrundeliegende Datenbankverbindung physisch keine andere Partition öffnen kann.
- Generierte SQL wird vor Ausführung geprüft: nur ein einzelnes, lesendes SELECT/WITH-Statement, eine Sperrliste verhindert alles, was schreiben oder auf beliebige Dateien zugreifen könnte.
- Ein Zeilenlimit verhindert unbegrenzte Ergebnismengen.
- Das Audit-Log speichert Frage und generierte SQL — aber nie die tatsächlichen Ergebniswerte, um keine sensiblen Daten in Logs zu streuen.
Der Punkt dabei: KI-Unterstützung im regulatorischen Umfeld darf nicht bedeuten, die Kontrolle über die Daten und Prozesse aufzugeben. Guardrails sind kein nachträglicher Sicherheitsaufkleber, sondern Teil des Architekturentwurfs von Anfang an.
Fazit
Regulatorische Software hat momentan selten den Glamour eines Consumer-Produkts. Am Ende des Tages zählt hier die Funktion. In den vergangenen Tagen habe ich mich immer gefragt, warum. Eine hilfreiche und durchdachte GUI kann soviel erleichtern. Allem Anschein nach sind die UX-Teams immer die letzten, die an einem Produkt mitarbeiten dürfen.
Aber gerade hier zeigt sich, ob technische Entscheidungen tragfähig sind: Kann ich in einem Jahr noch erklären, warum ein Wert so gemeldet wurde? Kann ich einen Stichtag risikofrei neu berechnen, sofern nötig? Kann ich KI einsetzen, ohne die Kontrolle über sensible Daten zu verlieren?
Genau an diesen Fragen habe ich mein kleines Projekt ausgerichtet — und sie werden auch bestimmen, wohin es sich als Nächstes entwickelt (zweites Quellsystem, weiteres Meldungsmodul, erweiterte Regelabdeckung etc. pp).
Neben dem Punkt, ob und wieviel Zeit (abzüglich Arbeits- und Familienzeit) ich nach dem GTA6 Release haben werde 🙂 .
App Oberfläche
Hier zur Übersicht einmal die komplette GUI – sie exisitiert und funktioniert zumindest lokal einwandfrei.